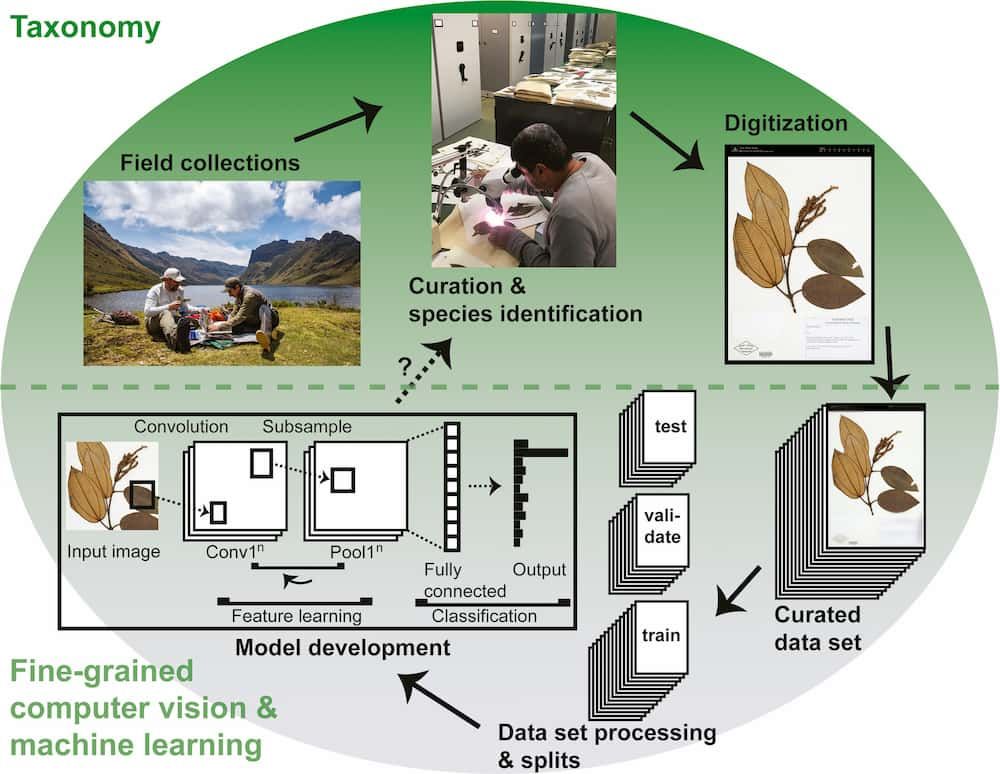

对植物多样性进行编目和描述新物种是一项关键且持续的任务,但由于缺乏专业知识和固有的缓慢过程而受到阻碍。 即使在理想条件下,在野外采集标本、将其描述为新物种并发布该描述也可能需要一到两年的时间。 更常见的是,这可能需要数十年。 世界各地的植物标本馆积压了多达一百万个身份不明的标本,并且被认为已经包含了 大多数未描述的植物物种. 利用机器学习并在高质量注释数据集上训练的计算机算法可能是解决方案的关键部分。
在发表于的一篇新文章中 在植物科学中的应用植物生物学机器学习特刊,主要作者 Damon P. Little 及其同事寻求方法 利用这种潜力. 作者举办了一场比赛 Kaggle数据科学平台 使用机器学习开发自动物种识别算法。 该小组提出了一个用于训练的数据集,其中包括代表野牡丹科 46,000 个物种的 683 多个标本室图像标本。 正如植物标本馆收藏的典型情况,其中一些物种以许多标本为代表,而其他物种则相对较少。
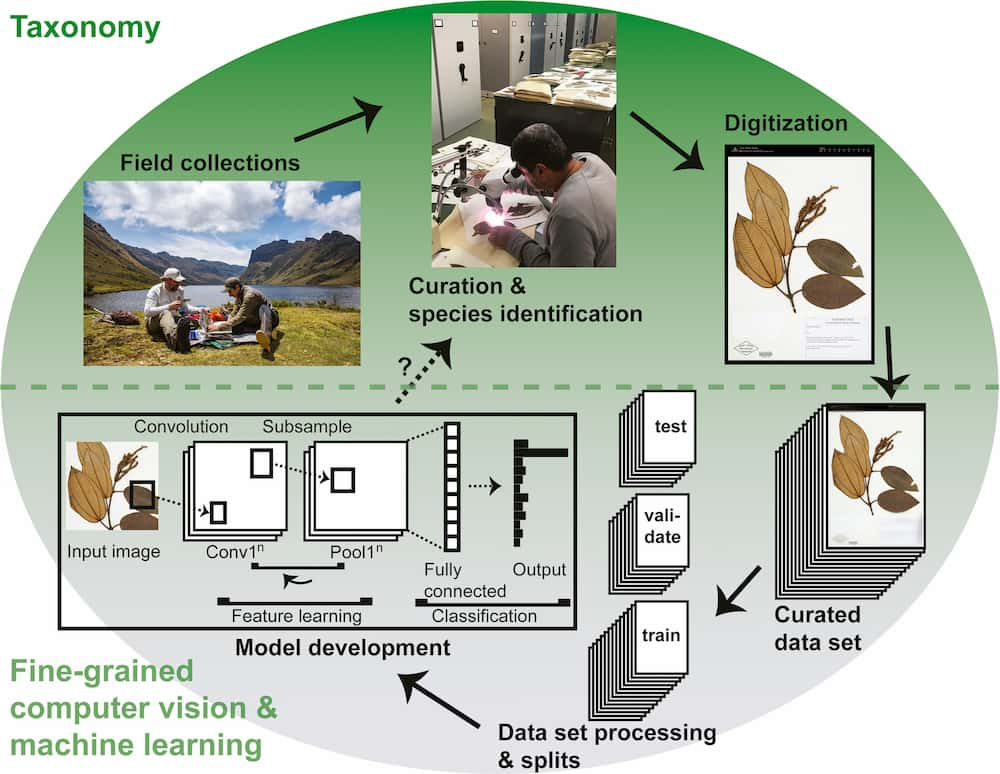
比赛持续了几个月,产生了由 254 个不同团队创建的 22 个模型。 排名前四的条目能够以超过 88% 的准确度识别物种。 获胜的团队来自中国的一家私营公司和一所公立大学,一个来自 Facebook AI Research 的团队,令人惊讶的是,一个人是一名受过培训的兽医,他“在假期里参加了比赛,并在手机上设计了模型。 ”
尽管竞赛结果超出预期,但问题仅仅解决了第一步。目前,这些算法只能将样本归类到其训练数据中最有可能的分类单元;它们无法将样本标记为未知或新物种。“这些算法的训练目的并非‘了解它们不知道什么’,而是为了根据训练数据给出输出,”论文合著者、纽约植物园植物基因组学副馆长芭芭拉·安布罗斯 (Barbara Ambrose) 表示。下一步是开发一种能够将样本标记为可能的新物种的算法。作者目前正在申请资金以应对这一挑战。
安布罗斯和利特尔正在努力开发一种工具,任何植物标本馆都可以用它来处理未鉴定的标本。“我们的想法是,用户提交一张标本照片,算法会给出五个最佳结果。我们认为这将有助于清理积压的标本,并减少将标本送至馆内专家鉴定的瓶颈。许多植物标本馆规模较小,可能缺乏分类学方面的专业知识,因此这项工具将有助于他们管理馆藏,”安布罗斯说。“这项工具的研发已经接近尾声,利特尔博士已经开发出一个原型,我们称之为……” 策展人我们需要更多资金和时间来完成这项工作。 策展人 使其更加完善,从而造福世界各地的植物标本馆。但愿这一天不会太遥远。”
本着这种精神,安布罗斯和利特尔最近主持了一场 第二届Kaggle比赛 这极大地扩展了第一个分类学的范围。“本次比赛共有153支队伍参赛,他们使用的数据集包含超过1万个样本,代表了超过32,000种维管植物。凭借本次比赛中开发的算法,我们已准备好进一步开发 策展人 并解决新物种识别的自动化问题。”