
转录因子 (TF) 和它们结合的 DNA 位点 (TF-DNA) 是作物改良的良好目标,因为它们控制基因表达。 虽然过去十年的技术发展促进了许多 TF 的 DNA 结合偏好的表征,但许多仍未被识别。 新文章发表于 在硅片 Plants 描述了为寻找候选 TF 结合位点而创建的机器学习模型.
佐治亚大学生物信息学研究所的研究生 Sohyun Bang 女士和合著者建立了一个预测模型,该模型可以将基因组区域分类为来自基因组 DNA 的 TF 结合和 TF 非结合类。 作者选择重点检测玉米和大豆中的生长素响应因子 (ARF) TF 家族成员,因为生长素在植物生长发育中起着至关重要的作用,并且在物种间进化上是保守的。
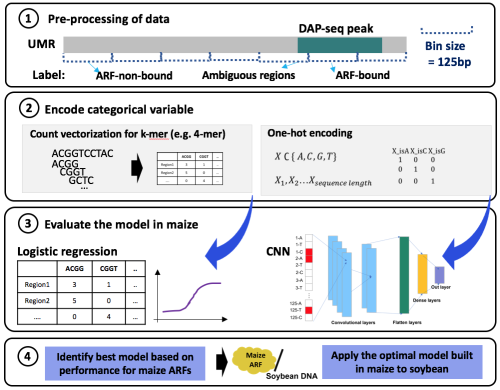
由于数据不平衡,这意味着大部分基因组并非由 ARF 结合事件组成,因此作者冒着产生高假阳性率的风险。 因此,他们通过限制用于非甲基化区域的数据来减少不由 ARF 结合事件组成的数据量,与基因组中的甲基化区域相比,这些区域高度丰富了 TF-DNA 相互作用(图 1)。
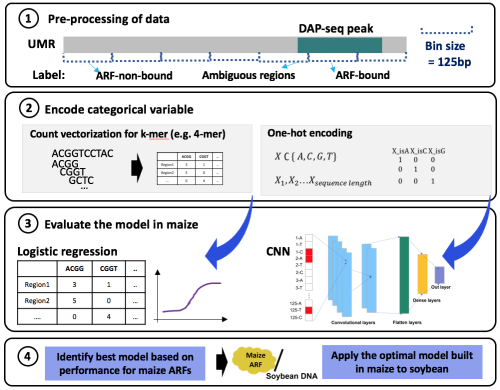
机器学习算法需要数字变量,而不是分类核苷酸序列。 因此,作者使用两种方法测试了用一个或多个数值变量对分类变量 (A、T、G、C) 进行编码(图 2):
- 单热编码将 DNA 视为具有四个通道的固定长度的一维序列。 例如,如果A、C、G、T分别编码为(1 1 0)、(0 0 1)、(0 0 0)、(1 0 0),则序列ATTGC将转化为((0 1 0), (0 0 0), (0 0 0), (0 0 0), (1 0 1)). 使用卷积神经网络对编码的 DNA 序列进行分类。
- 使用 k-mer 的计数矢量化描述了沿其长度(长度称为 k)的短 DNA 序列。 例如,当有一组AATTG序列时,3-mer的标记是AAT、ATT、TTG和TGC。 本文中测试的 k 为 5 – 9 个碱基对,最终选择使用 7-mer,因为它产生的假阴性率最低。 逻辑回归适用于计数矢量化特征。
使用这些方法,开发和训练了两个模型,以使用数据子集学习 TF 结合和 TF 未结合序列的不同模式。 然后使用剩余数据运行模型以预测 TF 结合或 TF 未结合区域。 每个模型的预测准确性都根据已知的 TF 结合和 TF 未结合事件进行了评估,作者使用 DNA 亲和纯化和测序(DAP-seq,图面板 3)的峰确定了这些事件。
准确预测的 TF 结合和 TF 未结合事件的总数揭示了预测模型的高精度,但其局限性是它们经常忽略高频 TF 未结合事件。
作者发现,one-hot 和 k-mer 这两种编码方法具有相似的 TF 预测准确度 (76-78%) 和相似但较高 (41-46%) 的假阴性率。
作者选择继续使用 k-mer 模型,并通过包括具有上采样和特征选择功能的逻辑回归分类器进一步提高其性能。 为了平衡包含比 ARF 绑定区域更多的非 ARF 绑定区域的数据,作者使用了上采样,它随机抽样少数类与训练集中的多数类大小相同。 通过识别 ARF 最有可能在不使用基序信息的情况下结合的 7 聚体基因组序列模式来执行特征选择。
由此,他们能够实现 91% 的 TF 预测准确度和 35% 的假阴性率。
最后,作者验证了用玉米建立的针对大豆基因组的最佳模型,以确定该模型是否可用于稳健地预测其他植物物种中的 TF-DNA 相互作用(图 4)。 为此,他们使用大豆基因组 DNA 作为输入,为相同的玉米 ARF 生成 DAP-seq 数据。 在训练玉米 ARF 结合区域并测试大豆数据后,他们实现了 70-84% 的 TF 预测准确度,但 ARF 成员的假阴性率很高 (36-89%)。
这项研究的发现表明,可以使用各种方法来预测物种内部和物种之间的 TF-DNA 相互作用,并取得不同程度的成功。
阅读文章:
Sohyun Bang、Mary Galli、Peter A Crisp、Andrea Gallavotti、Robert J Schmitz,使用机器学习识别转录因子-DNA 相互作用, in silico Plants,2022;,diac014, https://doi.org/10.1093/insilicoplants/diac014
该模型可在以下位置免费获得 https://github.com/schmitzlab/Identifying-transcription-factor-DNA-interactions-using-machine-learning